Kita akan mempelajari konsep Pod Autoscalling. Melalui latihan praktis, kita akan memeriksa pengaturan mendetail serta hal-hal penting yang perlu dipertimbangkan saat menerapkannya di lingkungan produksi (production).
Autoscaling adalah kemampuan sistem untuk menambah atau mengurangi alokasi sumber daya secara otomatis berdasarkan beban atau permintaan. Mekanisme ini bertujuan untuk menjaga performa aplikasi dan ketersediaan layanan (high availability). Fitur ini sangat populer di lingkungan cloud untuk mengelola elastisitas aplikasi dan infrastruktur secara otomatis.
Pada Kubernetes, autoscaling secara umum dapat dibagi menjadi dua: autoscaling untuk Pod dan untuk Node.
- Autoscaling Pod umumnya menggunakan HPA (Horizontal Pod Autoscaler) untuk menambah atau mengurangi jumlah pod secara horizontal.
- Autoscaling Node dapat menggunakan Cluster Autoscaler atau Karpenter guna menyesuaikan jumlah node tempat pod berjalan.
Poin Utama Pembahasan:
- Memahami konsep dasar AutoScaling.
- Memonitor penggunaan sumber daya Node dan Pod menggunakan Metrics-Server.
- Memahami mekanisme Horizontal Pod Autoscaler (HPA) yang menambah dan mengurangi pod seiring naik-turunnya beban pengguna.
Materi Praktik:
- Instalasi Metrics-Server.
- Praktik Pod Autoscaling (HPA).
Direktori GitHub untuk file sumber (source files) pada bab ini:
1. Komponen Utama Autoscaling
Mari kita pelajari komponen-komponen kunci yang diperlukan untuk mengonfigurasi autoscaling:
- Monitoring: Autoscaling menambah atau mengurangi beban berdasarkan metrik sistem. Oleh karena itu, kita membutuhkan sistem pemantauan (monitoring). Sistem ini mengumpulkan metrik performa seperti penggunaan CPU, memori, dan lalu lintas jaringan untuk mengetahui kondisi terkini.
- Penetapan Ambang Batas (Adjustment Criteria): Administrator menentukan kriteria dasar untuk penyesuaian skala. Contohnya, sistem akan menambah pod jika penggunaan CPU melebihi ambang batas, dan mengurangi pod saat berada di bawah ambang batas. Waktu reaksi (cooldown period) juga bisa diatur. Misalnya, jika lonjakan CPU sering terjadi tiba-tiba, Anda dapat menentukan waktu stabilisasi scaling-down selama 5 menit untuk mencegah perubahan skala yang terlalu sering (thrashing).
- Kebijakan Skala (Scaling Policy): Autoscaling mendukung dua pendekatan utama: Vertical Scaling dan Horizontal Scaling. Vertical Scaling menyesuaikan kapasitas resource pada instance yang sama (misal dari CPU request 0.5 core menjadi 1 Core). Sedangkan Horizontal Scaling menyesuaikan jumlah instance atau replika pod agar sesuai dengan beban kerja aplikasi.
Melalui integrasi ketiga komponen tersebut, sistem dapat merespons fluktuasi beban secara otomatis. Efisiensi sumber daya pun meningkat tanpa mengorbankan performa aplikasi. Pengelola sistem tidak perlu lagi melakukan intervensi manual setiap kali lalu lintas melonjak.
Di lingkungan cloud, autoscaling otomatis sangat fleksibel karena infrastrukturnya dapat bertambah sesuai kebutuhan. Sebaliknya, pada lingkungan on-premise, autoscaling sering dibatasi oleh jumlah server fisik (node) yang tersedia.
2. Memeriksa Penggunaan Sumber Daya dengan Metrics-Server
Sebelum menerapkan autoscaling, kita harus mengetahui metrik beban sistem terlebih dahulu. Di Kubernetes, komponen Metrics-Server diperlukan untuk memantau penggunaan CPU dan memori pada Pod dan Node.
Pada panduan ini, kita menggunakan ArgoCD dan Helm untuk proses instalasi. (Panduan lengkap mengenai Helm dibahas pada Bab 8; di sini kita hanya menuliskan ringkasan perintahnya).
$ (⎈ |switch-singapore-test:monitoring) helm repo add metrics-server
$ (⎈ |switch-singapore-test:monitoring) helm pull metrics-server/metrics-server --version 3.10.0
$ (⎈ |switch-singapore-test:monitoring) tar xvfz metrics-server-3.10.0.tgz
$ (⎈ |switch-singapore-test:monitoring) rm -rf metrics-server-3.10.0.tgz
$ (⎈ |switch-singapore-test:monitoring) mv metrics-server metrics-server-3.10.0
$ (⎈ |switch-singapore-test:monitoring) cd metrics-server-3.10.0
$ (⎈ |switch-singapore-test:monitoring) mkdir ci
$ (⎈ |switch-singapore-test:monitoring) cp values.yaml ci/
Ubah file Helm Value seperti di bawah ini:
ci/values.yaml
apiService:
  insecureSkipTLSVerify: true
Untuk mendeploy menggunakan ArgoCD, siapkan file aplikasi ArgoCD. Berpindahlah ke direktori argo-cd-app-of-apps:
$ (⎈ |switch-seoul-stage:kubecost) cd ../argo-cd-app-of-apps
Buat file CRD ArgoCD Application untuk Metrics-Server: templates/metrics-server-applications.yaml
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: metrics-server
  namespace: argocd
  finalizers:
    - resources-finalizer.argocd.argoproj.io
spec:
  destination:
    namespace: kube-system
    server: {{ .Values.spec.destination.server }}
  project: default
  source:
    path: metrics-server-3.10.0
    helm:
      valueFiles:
        - ci/values.yaml
    repoURL: {{ .Values.spec.source.repoURL }}
    targetRevision: {{ .Values.spec.source.targetRevision }}
Fitur Apps Application pada ArgoCD sudah dikonfigurasi dengan opsi syncPolicy/automated agar mengenali file aplikasi di dalam direktori templates secara otomatis:
apps-applications.yaml
syncPolicy:
  automated:
    prune: true
    selfHeal: true
Pada tampilan GUI ArgoCD, resource metrics-server akan muncul seperti gambar di atas. Klik tombol SYNC pada menu atas untuk menerapkan resource.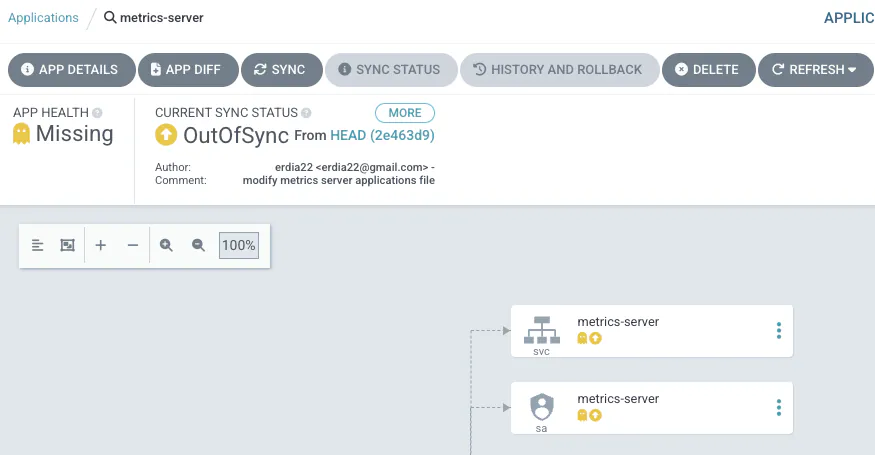
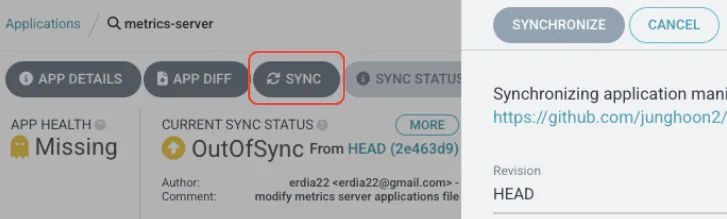
Pada tampilan GUI ArgoCD, resource metrics-server akan muncul seperti gambar di atas. Klik tombol SYNC pada menu atas untuk menerapkan resource.
Periksa namespace kube-system. Pod metrics-server kini telah aktif dan berjalan:
$ (⎈ |switch-singapore-test:kube-system) k get pod metrics-server-6f9cdd486c-2fqm2
NAME                              READY   STATUS    RESTARTS   AGE
metrics-server-6f9cdd486c-2fqm2   0/1     Running   0          24s
Metrics-Server mengambil metrik beban dari kubelet dan cAdvisor yang terpasang di setiap node. Metrik tersebut kemudian diekspos melalui API Server. Anda dapat melihat statistik beban dengan perintah kubectl top.
Melihat penggunaan sumber daya pada Node:
$ (⎈ |switch-singapore-test:kube-system) k top nodes
NAME                                                CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
ip-10-110-24-222.ap-southeast-1.compute.internal    171m         8%     2256Mi          31%
ip-10-110-47-109.ap-southeast-1.compute.internal    88m          4%     907Mi           12%
Melihat penggunaan sumber daya pada Pod:
$ (⎈ |switch-singapore-test:kube-system) k top pods
NAME                                                 CPU(cores)   MEMORY(bytes)
aws-load-balancer-controller-7d96db6884-nrcgf        2m           24Mi
aws-node-84wfr                                       3m           41Mi
(dihapus untuk ringkasan)
Proses instalasi Metrics-Server telah selesai.
3. Praktik HPA (Horizontal Pod Autoscaler)
HPA akan menyesuaikan jumlah replika pod secara dinamis saat penggunaan CPU atau memori melampaui target yang ditentukan.
Untuk mengujinya, kita akan mendeploy pod sampel terlebih dahulu.
php-apache.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: php-apache
spec:
  selector:
    matchLabels:
      run: php-apache
  replicas: 1
  template:
    metadata:
      labels:
        run: php-apache
    spec:
      containers:
      - name: php-apache
        image: registry.k8s.io/hpa-example
        ports:
        - containerPort: 80
        resources:
          limits:
            cpu: 500m
          requests:
            cpu: 200m
apiVersion: v1
kind: Service
metadata:
name: php-apache
labels:
run: php-apache
spec:
ports:
-----
port: 80
selector:
run: php-apache
.spec.template.spec.containers.resources.requests.cpu: 200m`
Bagian ini menentukan nilai CPU request untuk pod. Nilai `1000m` setara dengan `1 vCore`, sehingga `200m` berarti `0.2 Core`.
Contoh aplikasi di atas adalah citra resmi PHP-Apache dari dokumentasi Kubernetes yang dirancang untuk menghasilkan beban komputasi CPU saat menerima permintaan HTTP. Sekarang, terapkan manifes tersebut:
```bash
$ (⎈ |switch-singapore-test:default) k apply -f php-apache.yaml
deployment.apps/php-apache created
service/php-apache created

$ (⎈ |switch-singapore-test:default) k get deploy,svc
NAME                         READY   UP-TO-DATE   AVAILABLE   AGE
deployment.apps/php-apache   1/1     1            1           40s

NAME                 TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)   AGE
service/kubernetes   ClusterIP   172.20.0.1              443/TCP   59d
service/php-apache   ClusterIP   172.20.92.196           80/TCP    39s
Deployment dan service php-apache telah berhasil aktif. Selanjutnya, kita buat konfigurasi HPA dalam format YAML.
php-hpa.yaml
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: php-apache
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: php-apache
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 50
.spec.minReplicas: 1
Menetapkan batas minimum pod yang harus selalu berjalan (1 pod).
.spec.maxReplicas: 10
Menetapkan batas maksimum penambahan pod ketika beban tinggi (hingga 10 pod).
.spec.metrics.resource.name: cpu
Menentukan metrik CPU sebagai tolok ukur scaling.
.spec.metrics.resource.target.averageUtilization: 50
Menetapkan ambang batas rata-rata beban sebesar 50%. Angka ini dihitung dari nilai Resource Request yang disetel pada pod (bukan Resource Limit).
.spec.metrics.type: Resource
Menentukan tipe metrik bawaan sistem. Anda juga dapat menggunakan Custom Metrics untuk parameter lain seperti jumlah koneksi aktif atau latensi.
.spec.scaleTargetRef
Menentukan target deployment yang akan diskalakan oleh HPA (php-apache).
Terapkan resource HPA ke cluster:
$ (⎈ |switch-singapore-test:default) k apply -f php-hpa.yaml
horizontalpodautoscaler.autoscaling/php-apache created

$ (⎈ |switch-singapore-test:default) k get hpa
NAME         REFERENCE               TARGETS       MINPODS   MAXPODS   REPLICAS   AGE
php-apache   Deployment/php-apache   cpu: 0%/50%   1         10        1          24s
Saat awal dijalankan, penggunaan CPU masih berada di angka 0%/50%. Oleh karena itu, jumlah replika tetap berada di batas minimum (MINPODS = 1).
Sekarang, kita jalankan pod generator (load-generator) untuk memberikan beban trafik secara terus-menerus ke service php-apache:
$ (⎈ |switch-singapore-test:default) kubectl run -i --tty load-generator --rm --image=busybox:1.28 --restart=Never -- /bin/sh -c "while sleep 0.01; do wget -q -O- http://php-apache; done"
Pantau status HPA secara berkala. Kolom TARGETS akan meningkat tajam (misal dari 133% hingga lebih dari 200%):
$ (⎈ |switch-singapore-test:default) k get hpa
NAME         REFERENCE               TARGETS         MINPODS   MAXPODS   REPLICAS   AGE
php-apache   Deployment/php-apache   cpu: 239%/50%   1         10        5          3m15s
Ketika target utilisasi terlampaui, HPA otomatis menambah jumlah replika pod dari 1 menjadi beberapa pod untuk membagi beban trafik:
$ (⎈ |switch-singapore-test:default) k get pods
NAME                          READY   STATUS    RESTARTS   AGE
load-generator                1/1     Running   0          3m44s
php-apache-7495ff8f5b-66zzq   1/1     Running   0          113s
php-apache-7495ff8f5b-d4fdp   1/1     Running   0          3m23s
php-apache-7495ff8f5b-l6n86   1/1     Running   0          28m
php-apache-7495ff8f5b-ldljv   1/1     Running   0          3m23s
php-apache-7495ff8f5b-msx5z   1/1     Running   0          3m8s
HPA secara mandiri mengatasi lonjakan trafik tanpa bantuan manual dari pengelola sistem.
Setelah Anda menghentikan beban trafik (keluar dari proses load-generator), penggunaan CPU akan turun kembali. HPA secara perlahan akan mengurangi jumlah pod hingga kembali ke jumlah awal (MINPODS: 1).
4. Hal yang Perlu Diperhatikan Saat Menggunakan HPA
Terdapat beberapa pertimbangan teknis penting sebelum menerapkan HPA pada sistem produksi:
1. Fluktuasi Singkat (Flapping):
Beban lalu lintas web sering kali naik-turun dalam tempo cepat. Apabila skala pod bertambah dan berkurang terlalu sering, performa aplikasi justru dapat terganggu.
2. Kustomisasi behavior pada HPA:
Gunakan parameter behavior untuk mengendalikan jendela penstabilan (stabilization window) saat scale-down atau scale-up.
Berikut contoh konfigurasi kebijakan stabilitas:
behavior:
  scaleDown:
    stabilizationWindowSeconds: 300
    policies:
    - type: Percent
      value: 100
      periodSeconds: 15
  scaleUp:
    stabilizationWindowSeconds: 0
    policies:
    - type: Percent
      value: 100
      periodSeconds: 15
behavior.scaleDown.stabilizationWindowSeconds: 300
Memberikan jeda evaluasi selama 5 menit (300 detik) sebelum mengurangi pod. Langkah ini mencegah pod langsung dihapus saat beban turun sesaat.
behavior.scaleUp.stabilizationWindowSeconds: 0
Berbeda dengan proses turun skala, peningkatan skala diatur ke angka 0 detik. Hal ini dilakukan agar sistem dapat langsung merespons lonjakan trafik secepat mungkin.
Pembersihan Resource Praktik (Cleanup)
Setelah selesai menguji, hapus resource deployment, service, dan HPA yang telah dibuat:
$ (⎈ |switch-singapore-test:default) k delete -f php-apache.yaml -f php-hpa.yaml
deployment.apps "php-apache" deleted
service "php-apache" deleted
horizontalpodautoscaler.autoscaling "php-apache" deleted