Ketika aplikasi mengalami kendala performa atau lonjakan latency, menemukan sumber masalah secara instan adalah kunci menjaga stabilitas sistem. Melalui solusi Application Performance Management (APM) JENNIFER, tim Engineering dan DevOps dapat membedah masalah hingga ke tingkat baris kode secara sistematis.
Oleh karena itu, penerapan strategi Root Cause Analysis JENNIFER APM yang tepat akan membantu mempercepat pemulihan layanan secara terukur.
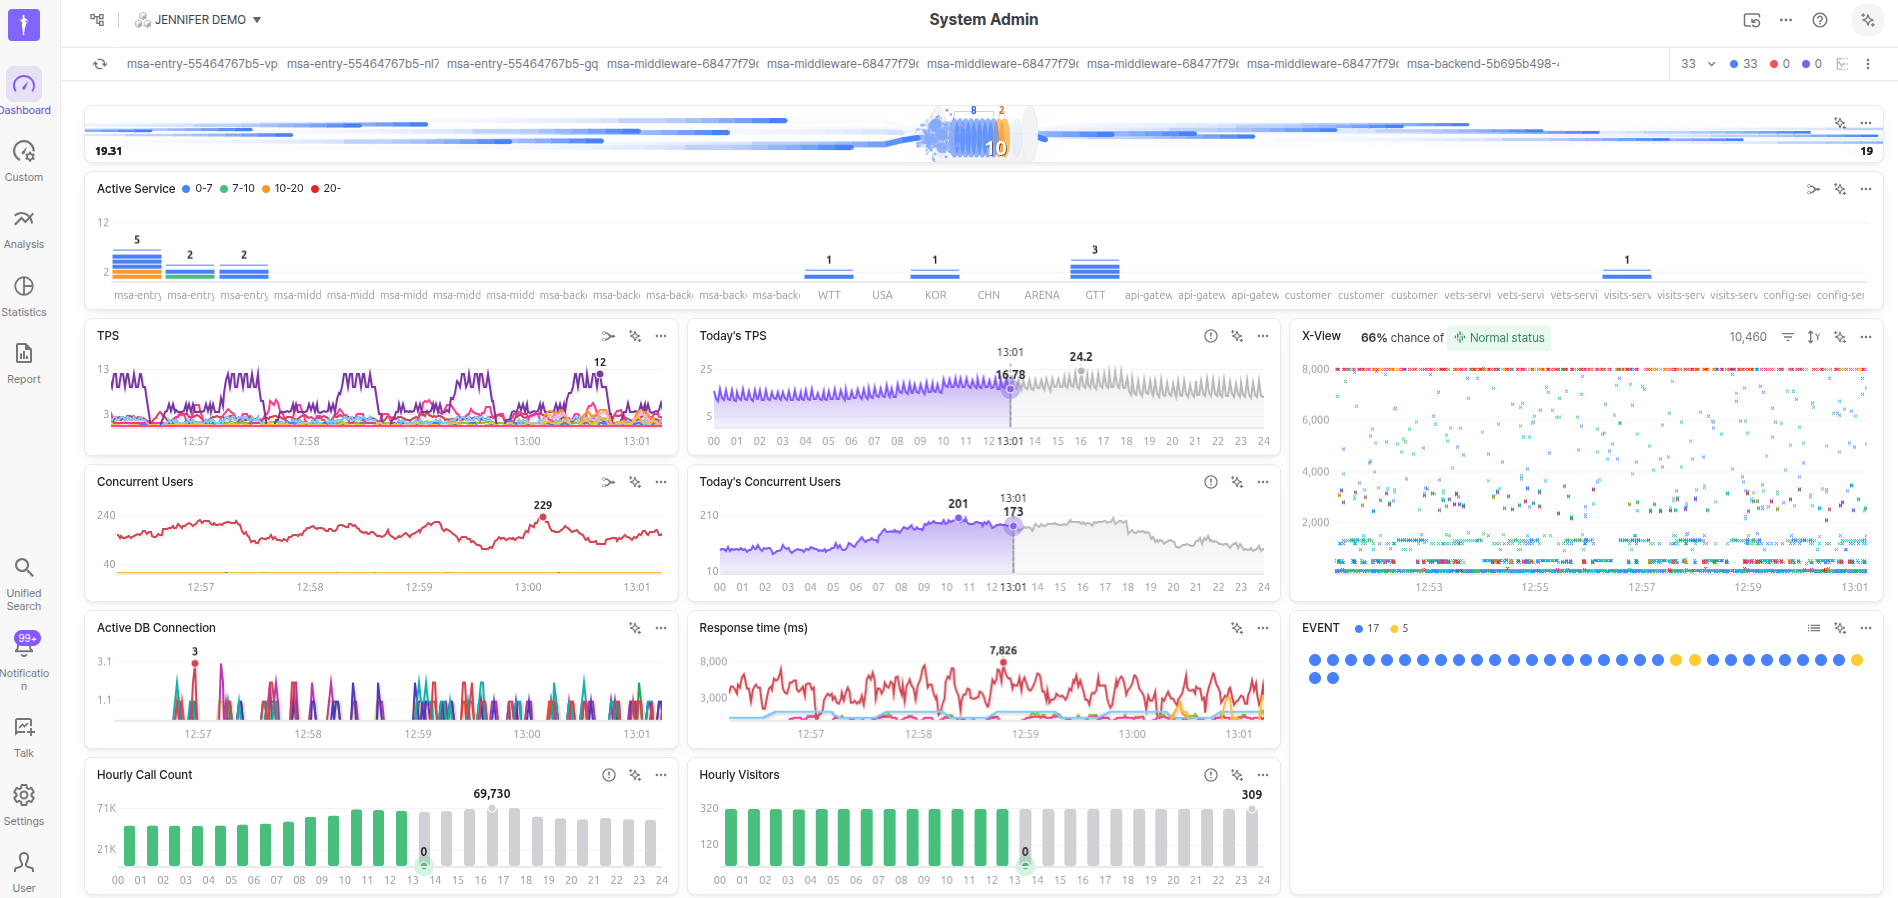
Dashboard Jennifer APM
1. Deteksi Pola Anomali Visual dengan X-View Chart
Langkah awal investigasi adalah memetakan transaksi bermasalah. Grafik X-View menyajikan setiap transaksi sebagai titik tunggal berdasarkan waktu respons dan waktu eksekusi.
- Identifikasi Cepat: Titik merah menandai transaksi yang terkena error atau exception.
- Pengenalan Pola: Sebaran titik memudahkan deteksi kendala spesifik, seperti SQL bottleneck atau antrean koneksi.
- Penyaringan Data: Seleksi area titik anomali secara langsung untuk memfilter transaksi berdasarkan IP client, ID pengguna, atau nama aplikasi.
2. Bedah Detail Transaksi Lewat X-View Transaction Analysis
Setelah memilah transaksi bermasalah, langkah berikutnya adalah memeriksa profil eksekusi secara mendalam.
- Timeline & Call Tree: Menampilkan urutan pemanggilan metode serta query SQL untuk menemukan fungsi yang memicu perlambatan.
- Analisis SQL & BIND Variable: Memeriksa teks perintah SQL, nilai parameter BIND variable, serta durasi pengambilan data database.
- External Calls & Exceptions: Melacak jeda waktu pada panggilan API eksternal sekaligus membaca stack trace error secara akurat.
Baca Juga : Mengapa Pemantauan Layanan Aplikasi Sangat Penting Bagi DevOps?
3. Diagnosa Real-Time Melalui Menu Active Service
Untuk menangani transaksi lambat yang masih aktif berjalan di server, fitur Active Service menyediakan visibilitas langsung.
- Equalizer Chart: Memantau jumlah active service yang sedang diproses oleh Web Application Server (WAS).
- Active Stack Trace: Menampilkan waktu berjalan, konsumsi CPU, dan transaksi macet agar tim dapat mengambil tindakan pada thread terkait sebelum server crash.
4. Lacak Ketergantungan Layanan via Topology Map
Pada arsitektur cloud dan microservices, sumber kegagalan kerap berpindah antar-komponen.
- GUID & Relative Call: Menghubungkan seluruh rantai panggilan antar-layanan menggunakan unique identifier yang seragam.
- Topology Map: Menampilkan visualisasi interaksi antar node server, sehingga titik penyebab hambatan dalam ekosistem terdistribusi langsung terlihat.
5. Korelasikan Metrik dengan Sumber Daya Infrastruktur
Performa aplikasi sering kali dipengaruhi oleh keterbatasan kapasitas hardware. JENNIFER memadukan data transaksi dengan metrik server secara simultan.
- Beban CPU: Memantau lonjakan utilisasi processor yang disebabkan oleh proses aplikasi tertentu.
- Heap Memory & Garbage Collection: Mengawasi alokasi memori guna mengantisipasi memory leak serta frekuensi proses Garbage Collection yang berlebihan.
Melalui visualisasi X-View, pembedahan thread berjalan, dan integrasi metrik infrastruktur, Root Cause Analysis JENNIFER APM mampu menekan Mean Time to Resolution (MTTR) secara signifikan.
Bagaimana alur analisis akar masalah yang saat ini berjalan di infrastruktur produksi Anda? Tuliskan pengalaman dan kendala Anda pada kolom komentar.
Apakah Anda ingin mengoptimalkan performa server bisnis Anda? Khusus untuk pengguna baru, dapatkan kesempatan menikmati fasilitas free trial premium selama 30 hari dari JENNIFER APM secara gratis dengan [Klik Di Sini].