Karpenter secara aktif mengubah jumlah node untuk mengoptimalkan biaya infrastruktur. Saat pod baru membutuhkan sumber daya, Karpenter akan membuat node baru yang paling hemat biaya sesuai konfigurasi resources.requests. Selain itu, Karpenter menghapus node lama yang utilisasinya rendah dan memindahkan pod yang berjalan di atasnya ke node baru.
Selama proses optimasi ini berlangsung, pod lama akan dihapus dan pod baru akan dijalankan. Agar restart pod tidak mengganggu ketersediaan layanan pelanggan, Anda memerlukan opsi seperti terminationGracePeriodSeconds, PodDisruptionBudget (PDB), dan pengelolaan status node. Pada bab ini, kita akan membahas cara menerapkan opsi-opsi penting tersebut.
1. Graceful Shutdown
Ketika terjadi autoscaling akibat naik-turunnya trafik pengguna, Karpenter akan menyesuaikan jumlah dan tipe node secara dinamis guna menekan pengeluaran.
Dibandingkan dengan Cluster Autoscaler konvensional, Karpenter melakukan perubahan node secara lebih sering. Berkat penyesuaian otomatis ini, biaya instans EC2 dapat berkurang sekitar 30%. Namun, jika sebuah node dihentikan mendadak, pod yang berjalan di dalamnya juga ikut terhenti sehingga berisiko menimbulkan gangguan layanan. Oleh sebab itu, konfigurasi graceful shutdown wajib disiapkan agar pod dapat berhenti secara bertahap dan aman.
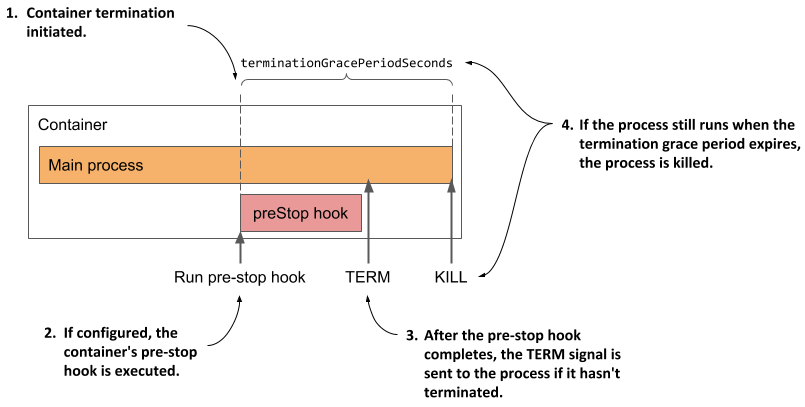
Saat node (atau administrator) menerima sinyal terminasi (terminating), Kubernetes menjalankan proses penghentian pod dengan urutan berikut:
- Pod dikeluarkan dari endpoint Service sehingga tidak lagi menerima permintaan (request) baru dari klien.
- Status node dan pod diperbarui menjadi
Terminatingpada databaseetcddi Control Plane. - Kubernetes memanggil hook
preStoppada seluruh kontainer di dalam pod (jika didefinisikan). HandlerpreStopberguna untuk menyelesaikan tugas pembersihan sebelum proses mati, seperti merampungkan penyimpanan data atau menutup koneksi database. - Setelah eksekusi
preStopselesai, Kubernetes mengirimkan sinyalSIGTERMke semua kontainer. Sinyal ini memberi instruksi pada proses aplikasi untuk bersiap berhenti secara normal (graceful). - Pod kemudian menunggu selama durasi yang ditentukan pada
terminationGracePeriodSeconds. Pada fase ini, kontainer berupaya menyelesaikan semua proses yang tersisa. - Apabila batas waktu habis dan kontainer belum juga berhenti, Kubernetes mengirimkan sinyal
SIGKILLuntuk mematikan proses kontainer secara paksa.
Secara default, nilai terminationGracePeriodSeconds pada Kubernetes adalah 30 detik. Jika aplikasi membutuhkan waktu lebih lama untuk menyelesaikan transaksi (misalnya layanan panggilan VoIP di mana sesi telepon pelanggan tidak boleh terputus tiba-tiba), Anda dapat menambah durasi tersebut di file YAML—bahkan hingga beberapa jam (contoh: 4 jam atau 14.400 detik) sembari menempatkan pod sensitif pada node khusus.
Mari kita amati mekanismenya melalui contoh sederhana berikut:
busybox-graceful-shutdown-pod.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pods-termination-grace-period-seconds
spec:
  containers:
  - command:
    - sleep
    - "3600"
    image: busybox
    name: pods-termination-grace-period-seconds
  terminationGracePeriodSeconds: 5 # Waktu tunggu sebelum mengubah sinyal TERM menjadi sinyal KILL
Pada manifes di atas, terminationGracePeriodSeconds ditentukan selama 5 detik. Ketika menerima perintah terminasi, pod tidak langsung terhapus seketika, melainkan menunggu 5 detik hingga proses selesai.
Jalankan pod busybox tersebut:
(jerry-test:default)k8s-class:jerry$ cd karpenter/
(jerry-test:default)k8s-class:jerry$ k apply -f busybox-graceful-shutdown-pod.yaml
pod/pods-termination-grace-period-seconds created
Hapus pod tersebut, lalu buka terminal lain untuk memantau perubahan status pod secara real-time menggunakan opsi -w (wait):
(jerry-test:default)k8s-class:jerry$ k delete pod pods-termination-grace-period-seconds
pod "pods-termination-grace-period-seconds" deleted
(jerry-test:default)k8s-class:jerry$ k get pod -w
NAME                                    READY   STATUS        RESTARTS   AGE   IP              NODE
pods-termination-grace-period-seconds   1/1     Running       0          3s    10.110.42.118   ip-10-110-47-109.ap-southeast-1.compute.internal
pods-termination-grace-period-seconds   1/1     Terminating   0          14s   10.110.42.118   ip-10-110-47-109.ap-southeast-1.compute.internal
pods-termination-grace-period-seconds   0/1     Terminating   0          20s   10.110.42.118   ip-10-110-47-109.ap-southeast-1.compute.internal
Output di atas membuktikan bahwa setelah menerima status Terminating (1/1), pod bertahan selama 5 detik sebelum benar-benar terhapus Terminating (0/1). Fitur ini sangat disarankan untuk seluruh pod layanan di lingkungan produksi agar sesi pengguna tetap aman.
2. Konfigurasi PodDisruptionBudget (PDB)
Ketika Karpenter mengosongkan suatu node, pod yang sedang aktif akan dihentikan lalu dijadwalkan ulang pada node lain. Pod masuk ke fase Terminating terlebih dahulu sebelum pod baru di node tujuan berstatus Running. Jeda waktu ini dapat memicu downtime singkat. Untuk mencegah penurunan ketersediaan layanan, Kubernetes menyediakan fitur PodDisruptionBudget (PDB).
PDB berfungsi membatasi jumlah pod yang boleh terhenti secara bersamaan selama proses pemeliharaan atau penggantian node terencana.
Sebagai ilustrasi:
- Anda memiliki 3 replika pod layanan web di dalam klaster.
- Agar beban tetap stabil, setidaknya 2 pod harus selalu berjalan setiap saat.
- Jika 2 pod terhenti bersamaan, kapasitas server akan turun drastis dan menyebabkan kegagalan layanan.
Aturan PDB mengatasi masalah tersebut melalui dua parameter utama:
minAvailable: Jumlah minimum pod yang harus selalu aktif (misalnyaminAvailable: 2).maxUnavailable: Jumlah maksimum pod yang diizinkan mati secara bersamaan (misalnyamaxUnavailable: 1).
Mari kita uji skenario PDB secara langsung. Kita akan menjalankan 2 replika pod pada satu node spesifik, lalu mengosongkan node tersebut (drain). Berkat PDB, Kubernetes tidak akan mematikan semua pod sekaligus jika syarat ketersediaan belum terpenuhi.
Buat manifes Deployment terlebih dahulu:
busybox-nodeSelector.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: busybox
  labels:
    app: busybox
spec:
  replicas: 2
  selector:
    matchLabels:
      app: busybox
  template:
    metadata:
      labels:
        app: busybox
    spec:
      containers:
      - command:
        - sleep
        - "3600"
        image: busybox
        name: busybox
      nodeSelector:
        kubernetes.io/hostname: ip-10-110-47-109.ap-southeast-1.compute.internal
Opsi nodeSelector digunakan untuk memastikan pod dijadwalkan pada node spesifik. Silakan ganti nilai hostname dengan nama node EKS Anda masing-masing.
Selanjutnya, buat konfigurasi PDB:
busybox-pdb.yaml
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: busybox
  namespace: default
spec:
  minAvailable: 1
  selector:
    matchLabels:
      app: busybox
spec.minAvailable: 1: Menjamin minimal 1 pod busybox harus selalu berstatus aktif dan siap melayani trafik.spec.selector.matchLabels: Menargetkan pod yang memiliki labelapp: busybox.
Terapkan kedua manifes tersebut ke dalam klaster:
(jerry-test:default)k8s-class:jerry$ k apply -f busybox-pdb.yaml -f busybox-nodeSelector.yaml
poddisruptionbudget.policy/busybox created
deployment.apps/busybox created

(jerry-test:default)k8s-class:jerry$ k get pdb
NAME      MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
busybox   1               N/A               1                     20s
Kolom ALLOWED DISRUPTIONS: 1 menunjukkan bahwa hanya 1 pod yang diperbolehkan dihentikan dalam satu waktu.
Sekarang, kita lakukan proses pengosongan node menggunakan perintah kubectl drain:
(jerry-test:default)k8s-class:jerry$ k drain ip-10-110-47-109.ap-southeast-1.compute.internal --ignore-daemonsets --delete-emptydir-data
Saat proses drain berjalan, Kubernetes membaca aturan PDB sehingga tidak mengizinkan penggusuran (eviction) yang melanggar batas minimum pod aktif. PDB menjadi benteng pertahanan vital agar operasional Karpenter tidak menyebabkan gangguan pada aplikasi pengguna.
3. Pengaturan Penjadwalan Node drain, cordon, dan uncordon
Kubernetes menyediakan utilitas perintah drain, cordon, dan uncordon untuk mengelola penjadwalan pod serta menjaga kestabilan klaster:
drain: Mengosongkan node secara aman dengan memindahkan pod ke node lain. Perintah ini umumnya dipakai saat pemeliharaan perangkat keras, penanganan node rusak, atau upgrade versi klaster.cordon: Menandai node agar tidak menerima pod baru (SchedulingDisabled). Perintah ini ideal digunakan jika Anda ingin mengisolasi node untuk perbaikan tanpa langsung mengusir pod yang sedang berjalan.uncordon: Membatalkan status isolasi node sehingga penjadwal (scheduler) Kubernetes dapat kembali menempatkan pod baru pada node tersebut.
Setelah pengujian PDB dan proses drain selesai pada tahap sebelumnya, periksa status node:
(jerry-test:default)k8s-class:jerry$ k get nodes -o wide ip-10-110-47-109.ap-southeast-1.compute.internal
NAME                                                STATUS                     ROLES   AGE   VERSION
ip-10-110-47-109.ap-southeast-1.compute.internal    Ready,SchedulingDisabled   <none>  8d    v1.26.4-eks-0a21954
Node saat ini berstatus SchedulingDisabled. Untuk mengaktifkannya kembali agar pod dapat dijadwalkan, jalankan perintah uncordon:
(jerry-test:default)k8s-class:jerry$ k uncordon ip-10-110-47-109.ap-southeast-1.compute.internal
node/ip-10-110-47-109.ap-southeast-1.compute.internal uncordoned
Periksa kembali kondisi node:
(jerry-test:default)k8s-class:jerry$ k get nodes -o wide ip-10-110-47-109.ap-southeast-1.compute.internal
NAME                                                STATUS   ROLES   AGE   VERSION
ip-10-110-47-109.ap-southeast-1.compute.internal    Ready    <none>  8d    v1.26.4-eks-0a21954
Node telah kembali ke status Ready dan siap menerima penjadwalan pod seperti semula.
Pembersihan Resource Praktik (Cleanup)
Setelah seluruh latihan selesai, bersihkan resource Deployment dan PDB agar tidak membebani klaster:
(jerry-test:default)k8s-class:jerry$ k delete deployments.apps busybox
deployment.apps "busybox" deleted

(jerry-test:default)k8s-class:jerry$ k delete pdb busybox
poddisruptionbudget.policy "busybox" deleted
Mengoptimalkan pengeluaran infrastruktur dengan Karpenter terbukti sangat efisien, namun stabilitas aplikasi tetap menjadi prioritas utama. Melalui penerapan Graceful Shutdown (terminationGracePeriodSeconds), pembatasan risiko dengan PodDisruptionBudget (PDB), serta kontrol pemeliharaan node via drain, cordon, dan uncordon, Anda dapat menekan biaya cloud tanpa khawatir memicu downtime atau memutus sesi pengguna yang sedang aktif.
Agar kesehatan node dan dampak perubahan skala pod terpantau menyeluruh, Anda juga membutuhkan visibilitas observabilitas yang andal. Pelajari bagaimana dashboard monitoring terpadu mempermudah kerja tim operasional melalui artikel Dashboard Kubernetes JENNIFER APM: Fitur Khusus untuk System Administrator K8s.
Tertarik membuktikan langsung performa dan kemudahan monitoring klaster Anda? Daftarkan diri Anda untuk mencoba Free Trial JENNIFER APM hari ini. Kunjungi juga layanan dan solusi teknologi kami selengkapnya di sindigilive.com. Jika memiliki pertanyaan teknis atau kebutuhan implementasi di lingkungan klaster Anda, jangan ragu untuk berdiskusi dengan tim kami!