Poin Utama
Mempelajari fitur Advanced POD Scheduling untuk memisahkan node tempat Pod dapat dijalankan demi stabilitas layanan, serta menjalankan Pod dari aplikasi yang sama pada node yang berbeda.
Latihan Praktik
- Menjalankan Pod pada node tertentu menggunakan konfigurasi Taint, Tolerations, dan Node Affinity.
- Mencegah Pod dijalankan pada node yang sama menggunakan Pod Anti-Affinity
Tautan GitHub
- https://github.com/junghoon2/k8s-class/tree/main/tolerations
- https://github.com/junghoon2/k8s-class/tree/main/affinity
Kebijakan penjadwalan bawaan (default) pada Kubernetes berfokus pada memaksimalkan pemanfaatan sumber daya (resource utilization) cluster serta memastikan ketersediaan Pod (availability). Jika tidak ada persyaratan khusus, Kubernetes akan menggunakan kebijakan bawaan ini untuk menempatkan Pod secara otomatis pada node mana pun yang dinilai sesuai. Fungsi penjadwalan ini dijalankan oleh Pod Penjadwal (Scheduler) yang berada di control plane. Pod Scheduler memutuskan ke node mana Pod baru di dalam cluster akan ditempatkan.
Pada Amazon EKS, control plane dikelola langsung oleh AWS sehingga Pod Scheduler tidak dapat diperiksa secara langsung. Namun, pada lingkungan native Kubernetes on-premise, Pod scheduler dapat dilihat seperti berikut:
$ (⎈ |alooo:kube-system) k get pod --selector component=kube-scheduler -o wide -n kube-system
NAME                     READY   STATUS    RESTARTS        AGE    IP              NODE      NOMINATED NODE   READINESS GATES
kube-scheduler-master1   1/1     Running   61 (12h ago)    126d   192.168.1.101   master1   <none>           <none>
kube-scheduler-master2   1/1     Running   87 (12h ago)    126d   192.168.1.102   master2   <none>           <none>
kube-scheduler-master3   1/1 Running 96 (12h ago) 126d 192.168.1.103 master3 <none> <none>
Opsi --selector digunakan untuk hanya menampilkan Pod yang memiliki Label tertentu. Saat menempatkan Pod, scheduler memilih node yang paling sesuai dengan mempertimbangkan total kapasitas sumber daya yang dapat dialokasikan oleh node (memori, kapasitas CPU, dll.) dan jumlah permintaan sumber daya (request) dari Pod tersebut. Selain itu, kondisi kesiapan node (healthiness) juga diperiksa agar Pod tidak dijalankan pada node yang bermasalah.
Hal yang perlu diperhatikan adalah jumlah permintaan sumber daya Pod mengacu pada kapasitas permintaan (request) yang tertulis di manifes, bukan penggunaan sumber daya aktual (actual resource usage) Pod saat ini. Ada kemungkinan penggunaan aktual tinggi tetapi permintaan sumber daya ditulis rendah, atau sebaliknya penggunaan aktual rendah namun permintaan sumber daya ditulis tinggi. Jika kapasitas sumber daya node yang tersedia tidak mencukupi, Pod dapat mengalami kegagalan OOM (Out Of Memory). Oleh karena itu, pengaturan Request harus dikonfigurasi dengan tepat berdasarkan penggunaan riil.
Fitur Advanced Pod Scheduling di Kubernetes menyediakan cara untuk menjadwalkan Pod secara lebih spesifik. Secara default, Kubernetes bebas menjadwalkan Pod ke node mana pun di dalam cluster seperti dijelaskan di atas. Namun, dalam situasi tertentu, Pod harus ditempatkan pada node tertentu. Dalam kasus seperti ini, Advanced Pod Scheduling dapat digunakan untuk mengontrol penjadwalan dengan lebih presisi.
1. Konfigurasi Taint, Tolerations, dan Node Affinity
Penulis memisahkan Pod yang berkaitan langsung dengan layanan utama dari Pod yang tidak berkaitan langsung namun berfungsi untuk operasional infrastruktur bersama (seperti monitoring, logging, ArgoCD, dll.) agar berjalan di grup node yang berbeda. Hal ini dilakukan karena Pod untuk pencarian log dan monitoring terkadang mengonsumsi banyak sumber daya, sehingga tidak mengganggu Pod layanan utama. Opsi yang digunakan untuk memisahkan Pod secara eksplisit seperti ini adalah taint dan toleration.
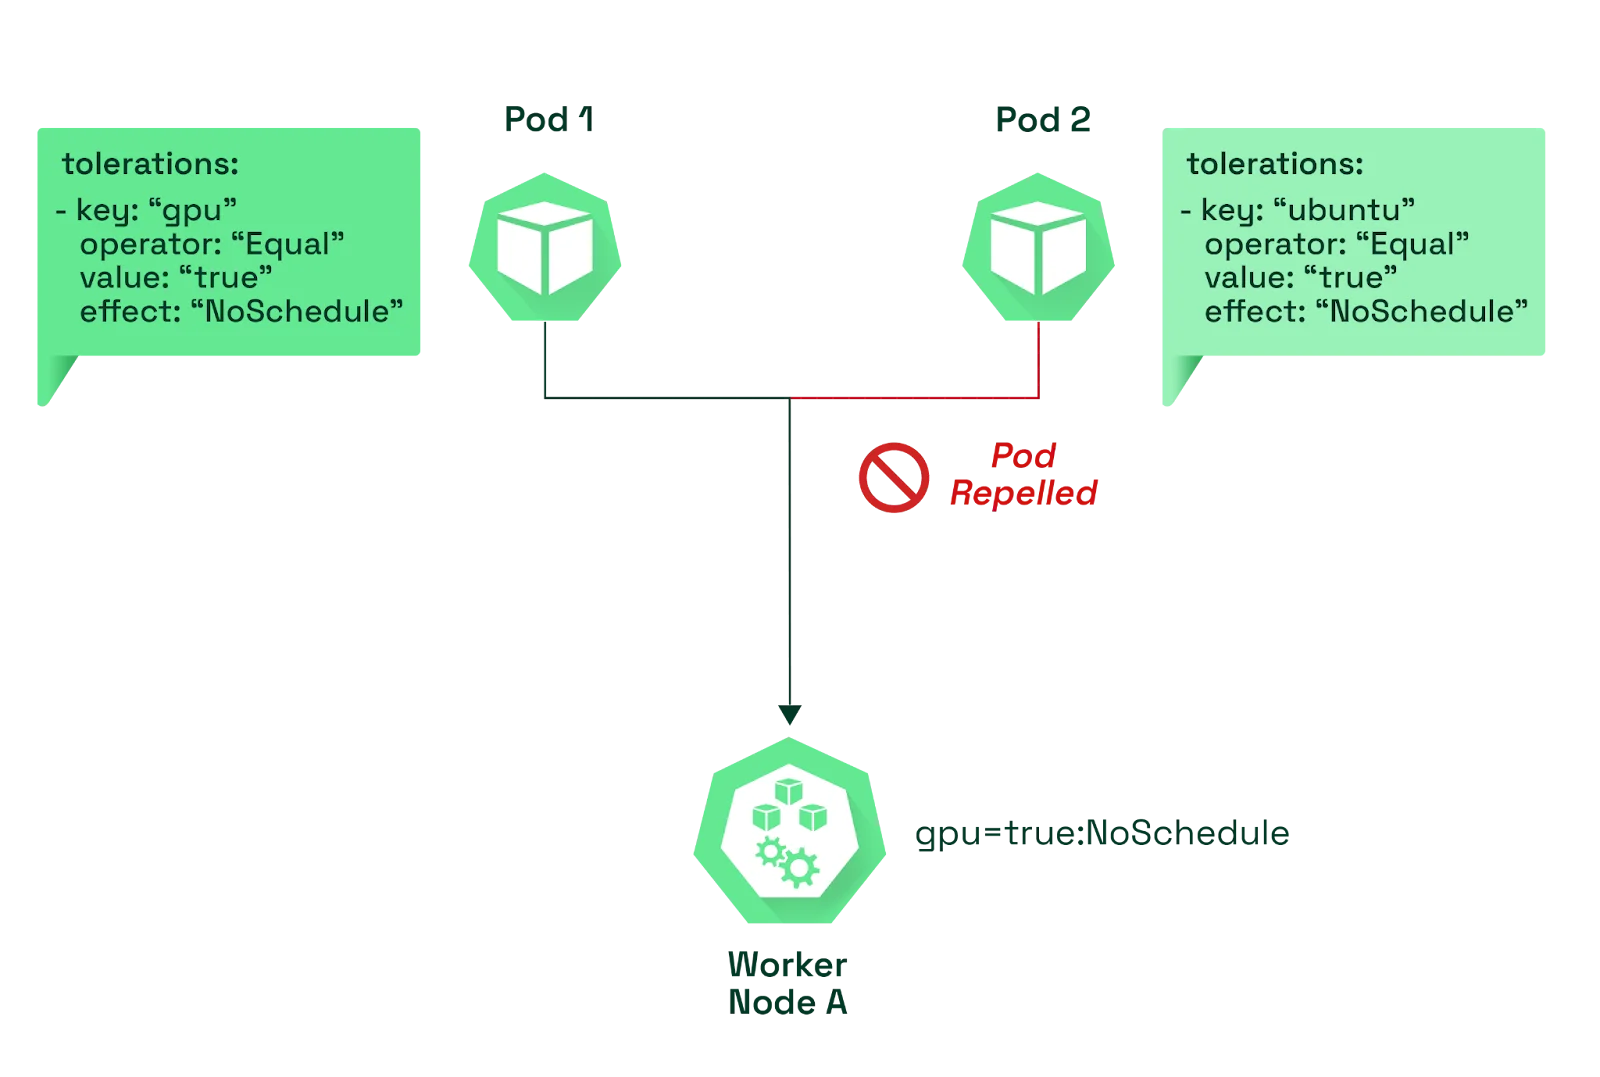
Konfigurasi Taint memberikan batasan khusus pada node tertentu. Saat taint diterapkan pada sebuah node, hanya Pod yang memiliki Toleration yang cocok dengan taint tersebut yang dapat dijadwalkan dan dijalankan pada node tersebut. Melalui mekanisme ini, node tertentu dapat didedikasikan untuk tujuan khusus, atau Pod tertentu hanya dijadwalkan ke node tertentu saja.
Perbedaan antara Taint dan Toleration adalah: Taint dikonfigurasikan pada Node, sedangkan Toleration dikonfigurasikan pada Pod. Jika Taint diterapkan pada Node dan konfigurasi Toleration yang cocok ditentukan pada Pod, maka Pod lain tidak akan dijadwalkan ke node tersebut dan hanya Pod dengan Toleration tersebut yang dapat berjalan.
Agar Pod dapat memilih node tertentu untuk dijadwalkan, digunakan konfigurasi nodeSelector atau nodeAffinity. Dalam praktiknya, Taint dikonfigurasikan pada Provisioner Karpenter seperti berikut untuk mengatur penjadwalan Pod secara presisi. Berikut adalah contoh penambahan konfigurasi Taint ke berkas manifes Provisioner Karpenter:
taint-provisioner.yaml
apiVersion: karpenter.sh/v1alpha5
kind: Provisioner
metadata:
  name: webrtc
  namespace: karpenter
spec:
  providerRef:
    name: default
  taints:
    - effect: NoSchedule
      key: node
      value: webrtc
  labels:
    node: webrtc
(bagian lain dihilangkan)
- spec.taints
Pengaturan Taint menggunakan format Key-Value. Key-Value dapat ditentukan secara bebas. Penulis menetapkan Key-Value menjadi node:webrtc. Dengan menetapkan effect: NoSchedule, Pod yang tidak memiliki toleration node:webrtc tidak akan dapat dijadwalkan ke node ini.
Selanjutnya, tambahkan konfigurasi tolerations dan nodeAffinity ke pengaturan Pod agar Pod dapat berjalan pada node yang memiliki konfigurasi Taint tersebut. Toleration adalah opsi yang memungkinkan Pod untuk di-deploy ke node dengan Taint. Sementara itu, nodeAffinity digunakan untuk menjadwalkan Pod ke node tertentu atau ke kelompok node tertentu. Menggunakan nodeAffinity memungkinkan penentuan kondisi yang lebih fleksibel dibandingkan nodeSelector, dan karena sintaksnya mirip dengan podAffinity, pengaturan nodeAffinity lebih banyak digunakan dibandingkan nodeSelector. Jika hanya ada konfigurasi Toleration tanpa nodeAffinity, Pod bisa saja dijadwalkan ke sembarang node lain, sehingga konfigurasi nodeAffinity ditambahkan bersamaan dengan Toleration.
nodeAffinity berbasis pada label node dan didefinisikan dengan menambahkan blok affinity pada kolom spec milik Pod. Node Affinity dapat memiliki 2 opsi berikut:
- RequiredDuringSchedulingIgnoredDuringExecution
Tipe ini mengharuskan (Required) Pod untuk dijadwalkan pada node atau grup node tertentu; jika kondisi tersebut tidak terpenuhi, Pod tidak akan dijadwalkan. Namun, jika Pod sudah berhasil dijadwalkan pada node tersebut, Pod tidak akan dipindahkan ke node lain meskipun kondisi node affinity berubah (Ignored).
- PreferredDuringSchedulingIgnoredDuringExecution
Pod diprioritaskan (Preferred) untuk dijadwalkan pada node atau grup node tertentu, tetapi jika tidak ada node yang memenuhi kriteria, Pod tetap dapat dijadwalkan ke node lain yang tidak memenuhi kondisi tersebut. Ini bersifat preferensi dan bukan keharusan yang mengikat.
Mari kita pelajari melalui latihan praktik berikut.
toleration-deploy.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-hello
  namespace: default
  labels:
    app: nginx
spec:
  replicas: 2
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginxdemos/hello
      tolerations:
      - key: "node"
        value: "webrtc"
        effect: "NoSchedule"
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: node
                operator: In
                values:
                - webrtc
tolerations
Konfigurasi Tolerations ditambahkan agar Pod dapat dijadwalkan ke node yang memiliki Taint. Nilai node:webrtc memungkinkan Pod di-deploy ke node yang memiliki Taint node:webrtc.
nodeAffinity
Konfigurasi nodeAffinity dibuat agar Pod hanya disebarkan ke node yang memiliki label node:webrtc. Opsi requiredDuringSchedulingIgnoredDuringExecution pada nodeAffinity ditambahkan agar Pod dipastikan hanya dijadwalkan ke node tertentu dan bukan ke node lainnya.
Sekarang, mari kita jalankan provisioner dan Pod tersebut.
$ (⎈ |switch-singapore-test:karpenter) k apply -f taint-provisioner.yaml
provisioner.karpenter.sh/webrtc created

$ (⎈ |switch-singapore-test:default) k apply -f tolerations-deploy.yml
deployment.apps/nginx-hello created
Pada awalnya, status Pod nginx-hello berada pada kondisi Pending. Mengapa demikian?
$ (⎈ |switch-singapore-test:default) k get pod -o wide
NAME                           READY   STATUS    RESTARTS   AGE   IP       NODE     NOMINATED NODE   READINESS GATES
nginx-hello-558fcbd7bb-rffrz   0/1     Pending   0          3s    <none>   <none>   <none>           <none>
nginx-hello-558fcbd7bb-x9xdt   0/1     Pending   0          3s    <none>   <none>   <none>           <none>
Hal ini terjadi karena belum ada node yang memiliki label node:webrtc sesuai kebutuhan nodeAffinity. Karpenter saat itu belum menyediakan node baru. Setelah menunggu sejenak, Provisioner Karpenter akan menyediakan node baru yang memiliki label node:webrtc.
$ (⎈ |switch-singapore-test:default) k get pod -o wide
NAME                           READY   STATUS    RESTARTS   AGE   IP              NODE
nginx-hello-558fcbd7bb-rffrz   1/1     Running   0          17m   10.110.14.130   ip-10-110-11-102.ap-southeast-1.compute.internal
nginx-hello-558fcbd7bb-x9xdt   1/1     Running   0          17m   10.110.14.131   ip-10-110-11-102.ap-southeast-1.compute.internal
Setelah beberapa saat, Pod berjalan secara normal pada node yang disediakan oleh Karpenter Provisioner. Seperti yang terlihat, dua Pod dijalankan pada node yang sama (ip-10-110-11-102.ap-southeast-1...)
2. Konfigurasi Pod Anti-Affinity
Jika beberapa Pod dari aplikasi yang sama berjalan pada node yang sama, kegagalan pada node fisik tersebut dapat menyebabkan gangguan pada ketersediaan seluruh layanan. Untuk mencegah hal ini, kita menggunakan fitur ‘Pod Anti-Affinity’ agar Pod-Pod tersebut tersebar dan tidak berjalan pada node yang sama.
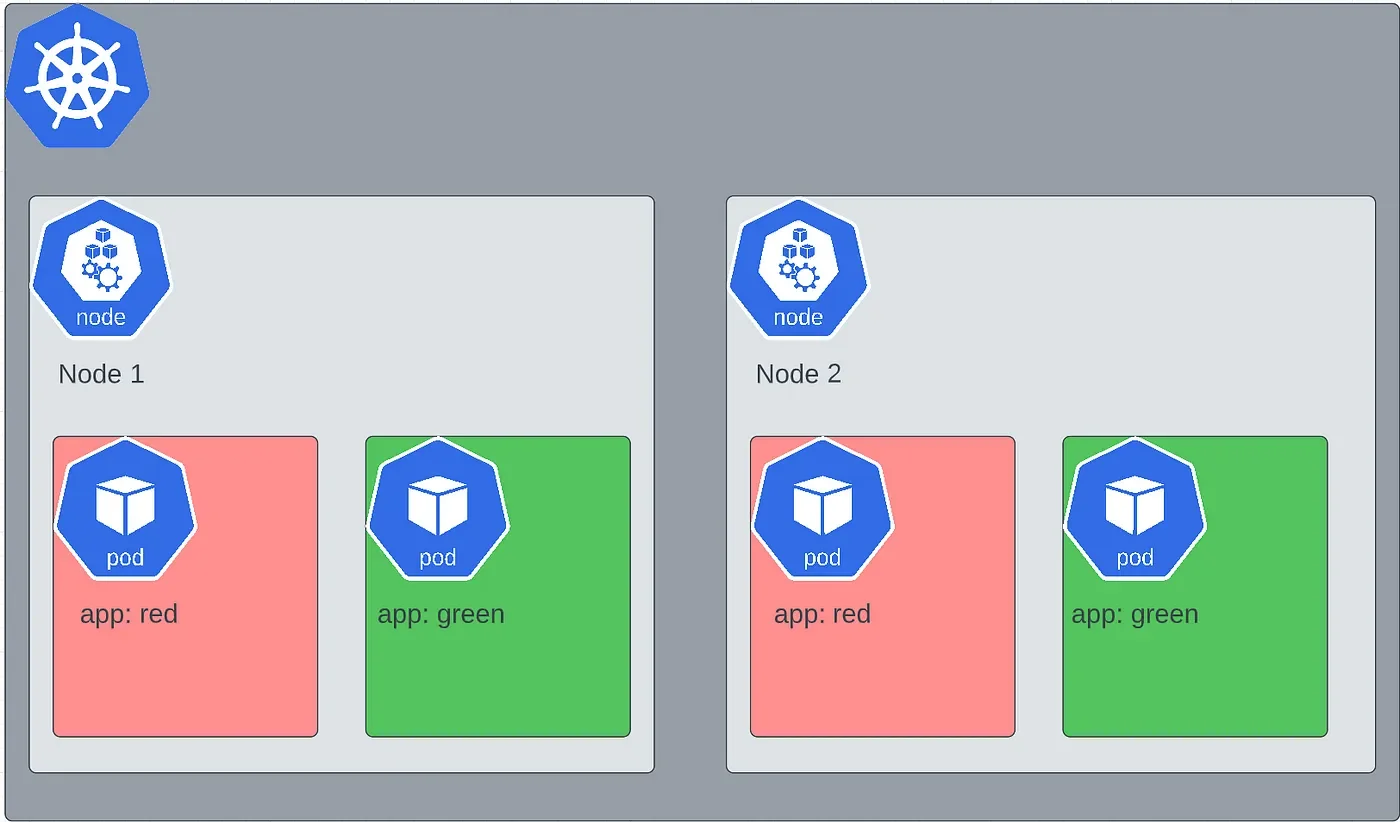
Konfigurasi ‘podAntiAffinity’ memungkinkan kita mengatur agar Pod tidak ditempatkan bersama Pod lain yang memiliki label identik pada domain topologi (topologyKey) yang sama.
Sama halnya dengan nodeAffinity, opsi yang tersedia adalah:
requiredDuringSchedulingIgnoredDuringExecution(kondisi wajib/mutlak)preferredDuringSchedulingIgnoredDuringExecution(kondisi preferensi/prioritas)
Berikut contoh manifes Deployment dengan Pod Anti-Affinity:
anti-affinity-deploy.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-anti-affinity
  namespace: default
spec:
  replicas: 2
  selector:
    matchLabels:
      app: nginx-anti
  template:
    metadata:
      labels:
        app: nginx-anti
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - nginx-anti
            topologyKey: "kubernetes.io/hostname"
      containers:
      - name: nginx
        image: nginxdemos/hello
. Affinity
Menambahkan opsi podAntiAffinity ke dalam kolom (field) affinity, sama seperti nodeAffinity sebelumnya.
. podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution
Pod dengan label yang sama wajib (required) tidak dijalankan pada node yang sama.
. labelSelector
Memilih Pod yang akan diterapkan Affinity berdasarkan labelnya. Label digunakan untuk berbagai jenis sumber daya (resources).
. topologyKey: kubernetes.io/hostname
Pod diklasifikasikan berdasarkan hostname dari node tempat Pod tersebut berjalan. Informasi topologi digunakan untuk menunjukkan penempatan fisik dan konektivitas jaringan dari node-node di dalam sebuah kluster. Jika Anda menentukan Topologi sebagai zone di AWS, Anda dapat mengaturnya agar berjalan di Availability Zone (AZ) yang berbeda.
Deploy Pod dengan properti Affinity tersebut.
$ k apply -f anti-affinity-deploy.yaml
deployment.apps/nginx-anti-affinity created
Sesuai yang diharapkan, Pod di-deploy ke 2 node yang berbeda.
$ (⎈ |switch-singapore-test:default) k get pod -o wide
NAME                     READY   STATUS    RESTARTS   AGE   IP              NODE                                               NOMINATED NODE   READINESS GATES
httpd-77d4584879-6l5bp   1/1     Running   0          20s   10.110.37.91    ip-10-110-47-109.ap-southeast-1.compute.internal   <none>           <none>
httpd-77d4584879-r4l29   1/1     Running   0          20s   10.110.28.221   ip-10-110-24-222.ap-southeast-1.compute.internal   <none>           <none>
Jadi, mari kita tambahkan 1 pod. Apa yang terjadi?
Karena saat ini hanya ada dua node, tiga pod tidak dapat dijalankan. Pod telah diatur dengan Anti-Affinity sehingga tidak dapat berjalan pada node yang sama.
$ (⎈ |switch-singapore-test:default) k scale deployment httpd --replicas 3
deployment.apps/httpd scaled
$ (⎈ |switch-singapore-test:default) k get pod -o wide
NAME                     READY   STATUS    RESTARTS   AGE     IP              NODE                                               NOMINATED NODE   READINESS GATES
httpd-77d4584879-6l5bp   1/1     Running   0          2m13s   10.110.37.91    ip-10-110-47-109.ap-southeast-1.compute.internal   <none>           <none>
httpd-77d4584879-r4l29   1/1     Running   0          2m13s   10.110.28.221   ip-10-110-24-222.ap-southeast-1.compute.internal   <none>           <none>
httpd-77d4584879-rbchf   0/1     Pending   0          13s     <none>          <none>                                             <none>           <none>
Status dari pod terakhir adalah ‘Pending’. Silakan periksa pesan detailnya.
$ (⎈ |switch-singapore-test:default) k describe pod httpd-77d4584879-rbchf
(생략)
Events:
  Type     Reason            Age   From               Message
  ----     ------            ----  ----               -------
  Warning  FailedScheduling  35s   default-scheduler  0/2 nodes are available: 2 node(s) didn't match pod anti-affinity rules. preemption: 0/2 nodes are available: 2 No preemption victims found for incoming pod..
Node yang sedang berjalan saat ini memiliki pengaturan podAntiAffinity, yang mengirimkan pesan bahwa pod tersebut tidak cocok untuk dieksekusi. Ketika sebuah pod berada dalam status ‘Pending’, Karpenter memeriksa kondisi pod tersebut untuk menjalankan node baru. Tunggu sebentar dan Karpenter akan meluncurkan node baru.
$ (⎈ |switch-singapore-test:default) k get pod -o wide
NAME                     READY   STATUS    RESTARTS   AGE     IP              NODE                                               NOMINATED NODE   READINESS GATES
httpd-77d4584879-6l5bp   1/1     Running   0          8m27s   10.110.37.91    ip-10-110-47-109.ap-southeast-1.compute.internal   <none>           <none>
httpd-77d4584879-r4l29   1/1     Running   0          8m27s   10.110.28.221   ip-10-110-24-222.ap-southeast-1.compute.internal   <none>           <none>
httpd-77d4584879-rbchf   1/1     Running   0          6m27s   10.110.47.139   ip-10-110-47-47.ap-southeast-1.compute.internal    <none>           <none>
3 pod tersebut kini berjalan pada node yang berbeda.
Jika Anda memeriksa dengan eks-node-viewer, node terakhir yang dijalankan adalah t3.micro, yaitu node dengan biaya paling rendah. Hal ini dikarenakan jumlah permintaan sumber daya (requests) dari pod httpd yang sedang dieksekusi dapat dijalankan pada node terkecil akibat tidak adanya pengaturan tertentu.

Perhatikan bahwa penggunaan pengaturan topologySpreadConstraints mendistribusikan pod ke node-node yang ditempatkan di Availability Zone (AZ) yang berbeda. Ketika ketersediaan pada tingkat AZ maupun node perlu dipastikan, pod di-deploy ke node-node yang berada di AZ yang berbeda. Gunakan pengaturan di bawah ini.
topologySpreadConstraints:
- maxSkew: 1
  topologyKey: topology.kubernetes.io/zone
  whenUnsatisfiable: DoNotSchedule
  labelSelector:
    matchLabels:
      app: dive-backend-admin-api-prod
topologySpreadConstraints alih-alih Pod Anti-Affinity.$ (⎈ |switch-singapore-test:default) k delete deployments.apps httpd deployment.apps "httpd" deleted